中青报·中青网记者 贾骥业
2026年,具身智能产业站在了一个关键节点上。
上半年,我国人形机器人出货量超过4万台,全球占比进一步提升至97%。工业和信息化部预计2026年全年人形机器人产量有望突破10万台。从制造端看,机器人“造出来”已不是问题,但从“造出来”到“用起来”,中间还有一道尚未完全打通的关口——数据。
训练机器人,需要大量真实场景中的物理交互数据作为“教材”。据统计,目前,全球可用的高质量真实数据仅为数十万至百万小时级,而机器人要迎来“ChatGPT时刻”,需要千万小时级的真实数据,供需之间存在量级差距。
如何推动人形机器人跨过“数据关”?具身智能训练场成了关键。最初,训练场因数据需求而建,随技术演进,训练场正从单纯的数据生产走向场景化的实景实训,成为真实物理环境中集数据生产、模型训练与能力验证于一体的关键基础设施,就像机器人的“学校”。
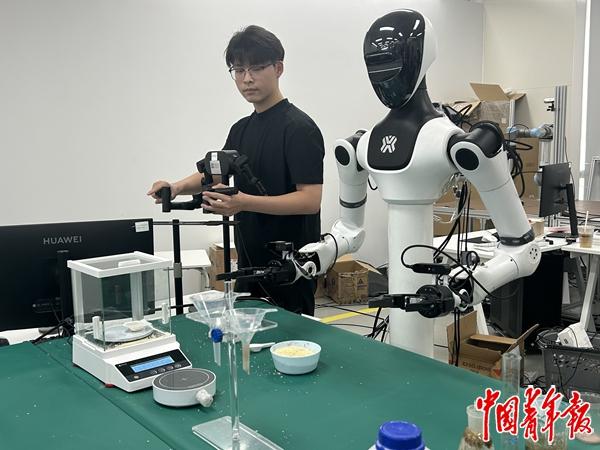
北京人形机器人创新中心具身智能机器人数据与训练基地,工作人员正在操作机器人采集数据。中青报·中青网记者 贾骥业/摄
日前,记者参加“新型工业化调研行”主题采访活动时来到国内首个基于真实场景的具身智能训练场——北京人形机器人创新中心具身智能机器人数据与训练基地(以下简称“北京人形数据与训练基地”),了解机器人如何在这里“学干活”。
在基地近6000平方米的实训空间里,家居、快递分拣、化学实验等场景分区铺开,数十种构型、上百台机器人在不同操作台前反复练习。
化学实验场景中,一款人形机器人正学习如何夹取托盘,并控制设备,称量固定克重粉末。这是一个精细化操作的实训场景,对机器人动作的精度要求很高。机器人身旁的数据采集员穿戴采集设备,小心翼翼地进行夹取物品、称量粉末等操作,机器人“有样学样”,一旁的电脑屏幕上,运动轨迹数据滚动更新,实时回传到数采系统中。
“这些动作看着很简单,但要想让机器人像人一样熟练,需要大量真实数据训练模型。”北京人形数据与训练基地项目经理刘磊介绍,数据采集员的每一次操作,都是在目标物体的形状、颜色、数量、位置等多种因素随机组合、动态变化场景中反复采集演示数据。通过学习,机器人不光会模仿,还可以逐步掌握适应不同环境的能力。
截至2026年6月,全国已建成启用超70家具身智能训练场,在建、规划40余家。但具身智能产业发展面临的“坎”,不光是数据少,还有高质量数据少。
北京人形数据与训练基地产品负责人史明威坦言,现在市面上很多训练场对外宣称“有多少万小时、亿小时的数据”,但实际上可用的是从中抽离出的高质量数据。“对行业来说,1万小时的高质量数据,可能比100万小时的重复数据更重要,因为很多数据其实是质量不合格或机器人用不起来的。”
什么样的数据才称得上“高质量”?刘磊以居家整理场景为例说:高质量数据就是机器人到了这个场景后,能自动判定哪些物品需要整理,哪些物品在摆放的过程中易碎需要小心谨慎操作……能精准做出这些指令,才算高质量。反过来,如果在操作过程中对目标判定是模糊、犹豫的,这种情况就是低质量数据。
“‘高质量’的定义,要根据模型的训练结果去验证得出来。”刘磊介绍,目前,基地已搭建典型机器人实训场景30余个。2025年12月,北京人形机器人创新中心面向全球开发者开源开放具身智能数据集RoboMIND,目前全球下载量已突破2000万次。
为提高数据生产的质量,基地构建了一条完整的数据闭环链路。海量数据采集后,会自动上传至数采系统后台,经过清洗、标注、校验、质检等环节,最终留下的有效、高质量数据将被用于算法模型的迭代训练。这些数据既服务自身机器人研发,也向外部客户提供。
在上述链路中,质检、标注等环节并非全靠人工。史明威告诉记者,他们会先利用AI进行自动化处理,之后再由人工做少量的质检和标注。“在采集任务开始之前,我们会对任务做详细拆解和SOP(标准化流程——记者注)定义,采集员对照定义和文档判断动作是否规范,质检发现问题会反馈给采集员,重新进行采集。”
实际上,闭环的关键在于数据加工完成之后。史明威提到,成品数据交付给模型团队,经测试验证后进行真机部署,正常来说一个闭环就结束了。“但实际上我们更关注这个模型部署到真机后,在实际作业中遇到哪些问题。我们会通过自动化手段,把问题回流到数采系统中进行分析,并针对性地再次进行数据采集,这就形成了一个大的闭环。”
当前,人形机器人在快递分拣、工业制造等场景已经有了应用,但不少具身智能训练场依然保留着上述场景。对此,刘磊以快递分拣为例解释说,分拣过程中的关键指标是效率和质量,现在快件种类还不够全面,如有软包裹、硬包裹、生鲜蔬菜、异常外观包裹等,需要大规模数据补充。
“地图类产品每年需要测试员驾车收集城市信息,因为城市会更新变化,机器人模型也要持续补充认知识别能力。”刘磊强调,具身智能赛道所有的数据都需要持续补充,不是说到了某一个节点就足够用了,“可能机器人这一生都不够用”。
如果每换一种机器人构型、每换一个场景,就要重新采集一遍数据,生产成本高,具身智能“用起来”的链条也难以持续。为此,北京人形数据与训练基地采用了多种方法,提高数据跨场景、跨本体复用的泛化性。
一方面,在指定场景下不过多限制采集任务和动作;另一方面,利用AI做模型泛化。同时,基地也会用头环等无本体设备让人来采,还会基于仿真数据进行模型训练,以保证数据的体量和模型面对不同形态的能力。现实生产生活也是数据的重要来源。史明威说:“靠人力安排任务的方式,只能解决少量问题,要想实现真正的泛化,还得把机器部署到真实场景中去,做整个数据闭环。”
据了解,北京人形数据与训练基地年数据产能可达18万小时,已对外交付近3万小时高质量数据。该基地将上百套无本体采集设备送到家庭、工业等真实环境,让数据采集从“样板间”走向真实产线。目前,这个基地正朝着产出百万小时级“高价值、高可用、可论证”的人形机器人交互数据迈进。
工业和信息化部数据显示,2025年,我国人工智能核心产业规模超过1.2万亿元,企业超过6200家。中国信息通信研究院近期发布的《具身智能训练场研究报告(2026年)》指出,近两年,具身智能训练场迅速在全国掀起建设热潮,但场景任务建设同质化、数据实际产能有限、数据多样性和流通性不足以及可持续商业模式尚未形成等问题逐渐凸显。
有关部门已关注到数据供给问题。记者从国家发展改革委了解到,下一步,将以具身智能实训场和应用中试基地为抓手统筹布局具身智能实训场,加强数据、模型、标准等要素供给。在数据方面,将构建高质量真机数据采集系统,提升具身智能数据供给质量与规模,破解具身智能训练“数据饥渴”问题。


关于中工网 | 版权声明 | 违法和不良信息举报电话:010-84151598 | 网络敲诈和有偿删帖举报电话:010-84151598
Copyright © 2008-2026 by www.workercn.cn. all rights reserved

 ×